lunes, 21 de diciembre de 2015

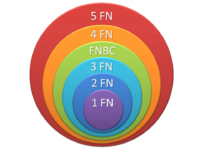
TERCERA FORMA
La tercera forma normal (3NF) es una forma normal usada en la normalización de bases de datos. La 3NF fue definida originalmente por E.F. Codd1 en 1971. La definición de Codd indica que una tabla está en 3NF si y solo si las tres condiciones siguientes se cumplen:
  • La tabla está en la segunda forma normal (2NF)
  • Ningún atributo no-primario de la tabla es dependiente transitivamente de una clave primaria
  • Es una relación que no incluye ningún atributo clave
Un atributo no-primario es un atributo que no pertenece a ninguna clave candidata. Una dependencia transitiva es una dependencia funcional X → Z en la cual Z no es inmediatamente dependiente de X, pero sí de un tercer conjunto de atributos Y, que a su vez depende de X. Es decir, X → Z por virtud de X → Y e Y → Z.
Una formulación alternativa de la definición de Codd, dada por Carlo Zaniolo2 en 1982, es ésta: Una tabla está en 3NF si y solo si, para cada una de sus dependencias funcionales X → A, por lo menos una de las condiciones siguientes se mantiene:
  • X contiene A, ó
  • X es una superclave, ó
  • A es un atributo primario (es decir, A está contenido dentro de una clave candidata)
La definición de Zaniolo tiene la ventaja de dar un claro sentido de la diferencia entre la 3NF y la más rigurosa forma normal de Boyce-Codd (BCNF). La BCNF simplemente elimina la tercera alternativa ("A es un atributo primario").
SEGUNDA FORMA
La segunda forma normal (2NF) es una forma normal usada en normalización de bases de datos. La 2NF fue definida originalmente por E.F. Codd1 en 1971. Una tabla que está en la primera forma normal (1NF) debe satisfacer criterios adicionales para calificar para la segunda forma normal. Específicamente: una tabla 1NF está en 2NF si y solo si, dada una clave primaria y cualquier atributo que no sea un constituyente de la clave primaria, el atributo no clave depende de toda la clave primaria en vez de solo de una parte de ella.
En términos levemente más formales: una tabla 1NF está en 2NF si y solo si ninguno de sus atributos no-principales son funcionalmente dependientes en una parte (subconjunto propio) de una clave primaria (Un atributo no-principal es uno que no pertenece a ninguna clave primaria).
Observe que cuando una tabla 1NF no tiene ninguna clave candidata compuesta (claves candidatas consisten en más de un atributo), la tabla está automáticamente en 2NF.
PRIMERA NORMA
La primera forma normal (1FN o forma mínima) es una forma normal usada en normalización de bases de datos. Una tabla de base de datos relacional que se adhiere a la 1FN es una que satisface cierto conjunto mínimo de criterios. Estos criterios se refieren básicamente a asegurarse que la tabla es una representación fiel de una relación1 y está libre de "grupos repetitivos".2
Sin embargo, el concepto de "grupo repetitivo", es entendido de diversas maneras por diferentes teóricos. Como consecuencia, no hay un acuerdo universal en cuanto a qué características descalificarían a una tabla de estar en 1FN. Muy notablemente, la 1FN, tal y como es definida por algunos autores excluye "atributos relación-valor" (tablas dentro de tablas) siguiendo el precedente establecido por (E.F. Codd) (algunos de esos autores son: Ramez Elmasri y Shamkant B. Navathe3 ). Por otro lado, según lo definido por otros autores, la 1FN sí los permite (por ejemplo como la define Chris Date).
NORMALIZACION DE BASE DE DATOS
El proceso de normalización de bases de datos consiste en designar y aplicar una serie de reglas a las relaciones obtenidas tras el paso del modelo entidad-relación almodelo relacional.
Las bases de datos relacionales se normalizan para:
  • Evitar la redundancia de los datos.
  • Disminuir problemas de actualización de los datos en las tablas.
  • Proteger la integridad de los datos.
En el modelo relacional es frecuente llamar tabla a una relación, aunque para que una tabla sea considerada como una relación tiene que cumplir con algunas restricciones:
  • Cada tabla debe tener su nombre único.
  • No puede haber dos filas iguales. No se permiten los duplicados.
  • Todos los datos en una columna deben ser del mismo tipo.

martes, 15 de diciembre de 2015

MODELO EN RED
Una base de datos de red es una base de datos conformada por una colección o set de registros, los cuales están conectados entre sí por medio de enlaces en una red. Elregistro es similar al de una entidad como las empleadas en el modelo relacional.
Un registro es una colección o conjunto de campos (atributos), donde cada uno de ellos contiene solamente un único valor almacenado.
El enlace es exclusivamente la asociación entre dos registros, así que podemos verla como una relación estrictamente binaria.
Una estructura de base de datos de red, llamada algunas veces estructura de plex, abarca más que la estructura de árbol: un nodo hijo en la estructura red puede tener más de un nodo padre. En otras palabras, la restricción de que en un árbol jerárquico cada hijo puede tener sólo un padre, se hace menos severa.
Así, la estructura de árbol se puede considerar como un caso especial de la estructura de red.El argumento principal a favor del modelo de red, en comparación con el modelo jerárquico, era que permitió un modelado más natural de relaciones entre entidades. Aunque el modelo extensamente fuera puesto en práctica y usado, esto falló en hacerse dominante por dos motivos principales. En primer lugar, la IBM decidió atenerse al modelo jerárquico con extensiones de semired en sus productos establecidos como IMS Y DL/I. En segundo lugar, eventualmente fue desplazado por el modelo relacional, que ofreció un nivel más alto, la interfaz más declarativo. Hasta principios de los años 1980 las ventajas del funcionamiento de las interfaces de bajo nivel de navegación ofrecidos por jerárquico y bases de datos de red eran persuasivas para muchos usos en gran escala, pero como el hardware se hizo más rápido, la productividad suplementaria y la flexibilidad del modelo relacional condujo a la caída en desuso gradual del modelo de red en el uso corporativo de la empresa.
MODELO RELACIONAL
El modelo relacional, para el modelado y la gestión de bases de datos, es un modelo de datos basado en la lógica de predicados y en la teoría de conjuntos.
Tras ser postuladas sus bases en 1970 por Edgar Frank Codd, de los laboratorios IBM en San José (California), no tardó en consolidarse como un nuevo paradigma en los modelos de base de datos.
Su idea fundamental es el uso de relaciones. Estas relaciones podrían considerarse en forma lógica como conjuntos de datos llamados tuplas. Pese a que esta es la teoría de las bases de datos relacionales creadas por Codd, la mayoría de las veces se conceptualiza de una manera más fácil de imaginar, pensando en cada relación como si fuese una tabla que está compuesta por registros (cada fila de la tabla sería un registro o "tupla") y columnas (también llamadas "campos").
Es el modelo más utilizado en la actualidad para modelar problemas reales y administrar datos dinámicamente.
MODELOS JERÁRQUICO


En ellas se organiza la información se organiza con un jerarquía en la que la relación entre las entidades de este modelo siempre es del tipo padre / hijo. De esta forma hay una serie de nodos que contendrán atributos y que se relacionarán con nodos hijos de forma que puede haber más de un hijo para el mismo padre (pero un hijo sólo tiene un padre).

Las entidades de este modelo se llaman 
segmentos y los atributos campos. La forma visual de este modelo es de árbol invertido, en la parte superior están los padres y en la inferior los hijos.

En una base de datos, un tipo de entidad es el equivalente de una tabla; cada registro individual es representado como una fila y un atributo como una columna. Los tipos de entidad son relacionados el uno con el otro usando 1: Trazar un mapa de n, también conocido como relacion de uno a varios. El ejemplo más aprobado de base de datos jerárquica modela es un IMS diseñado por la IBM.